
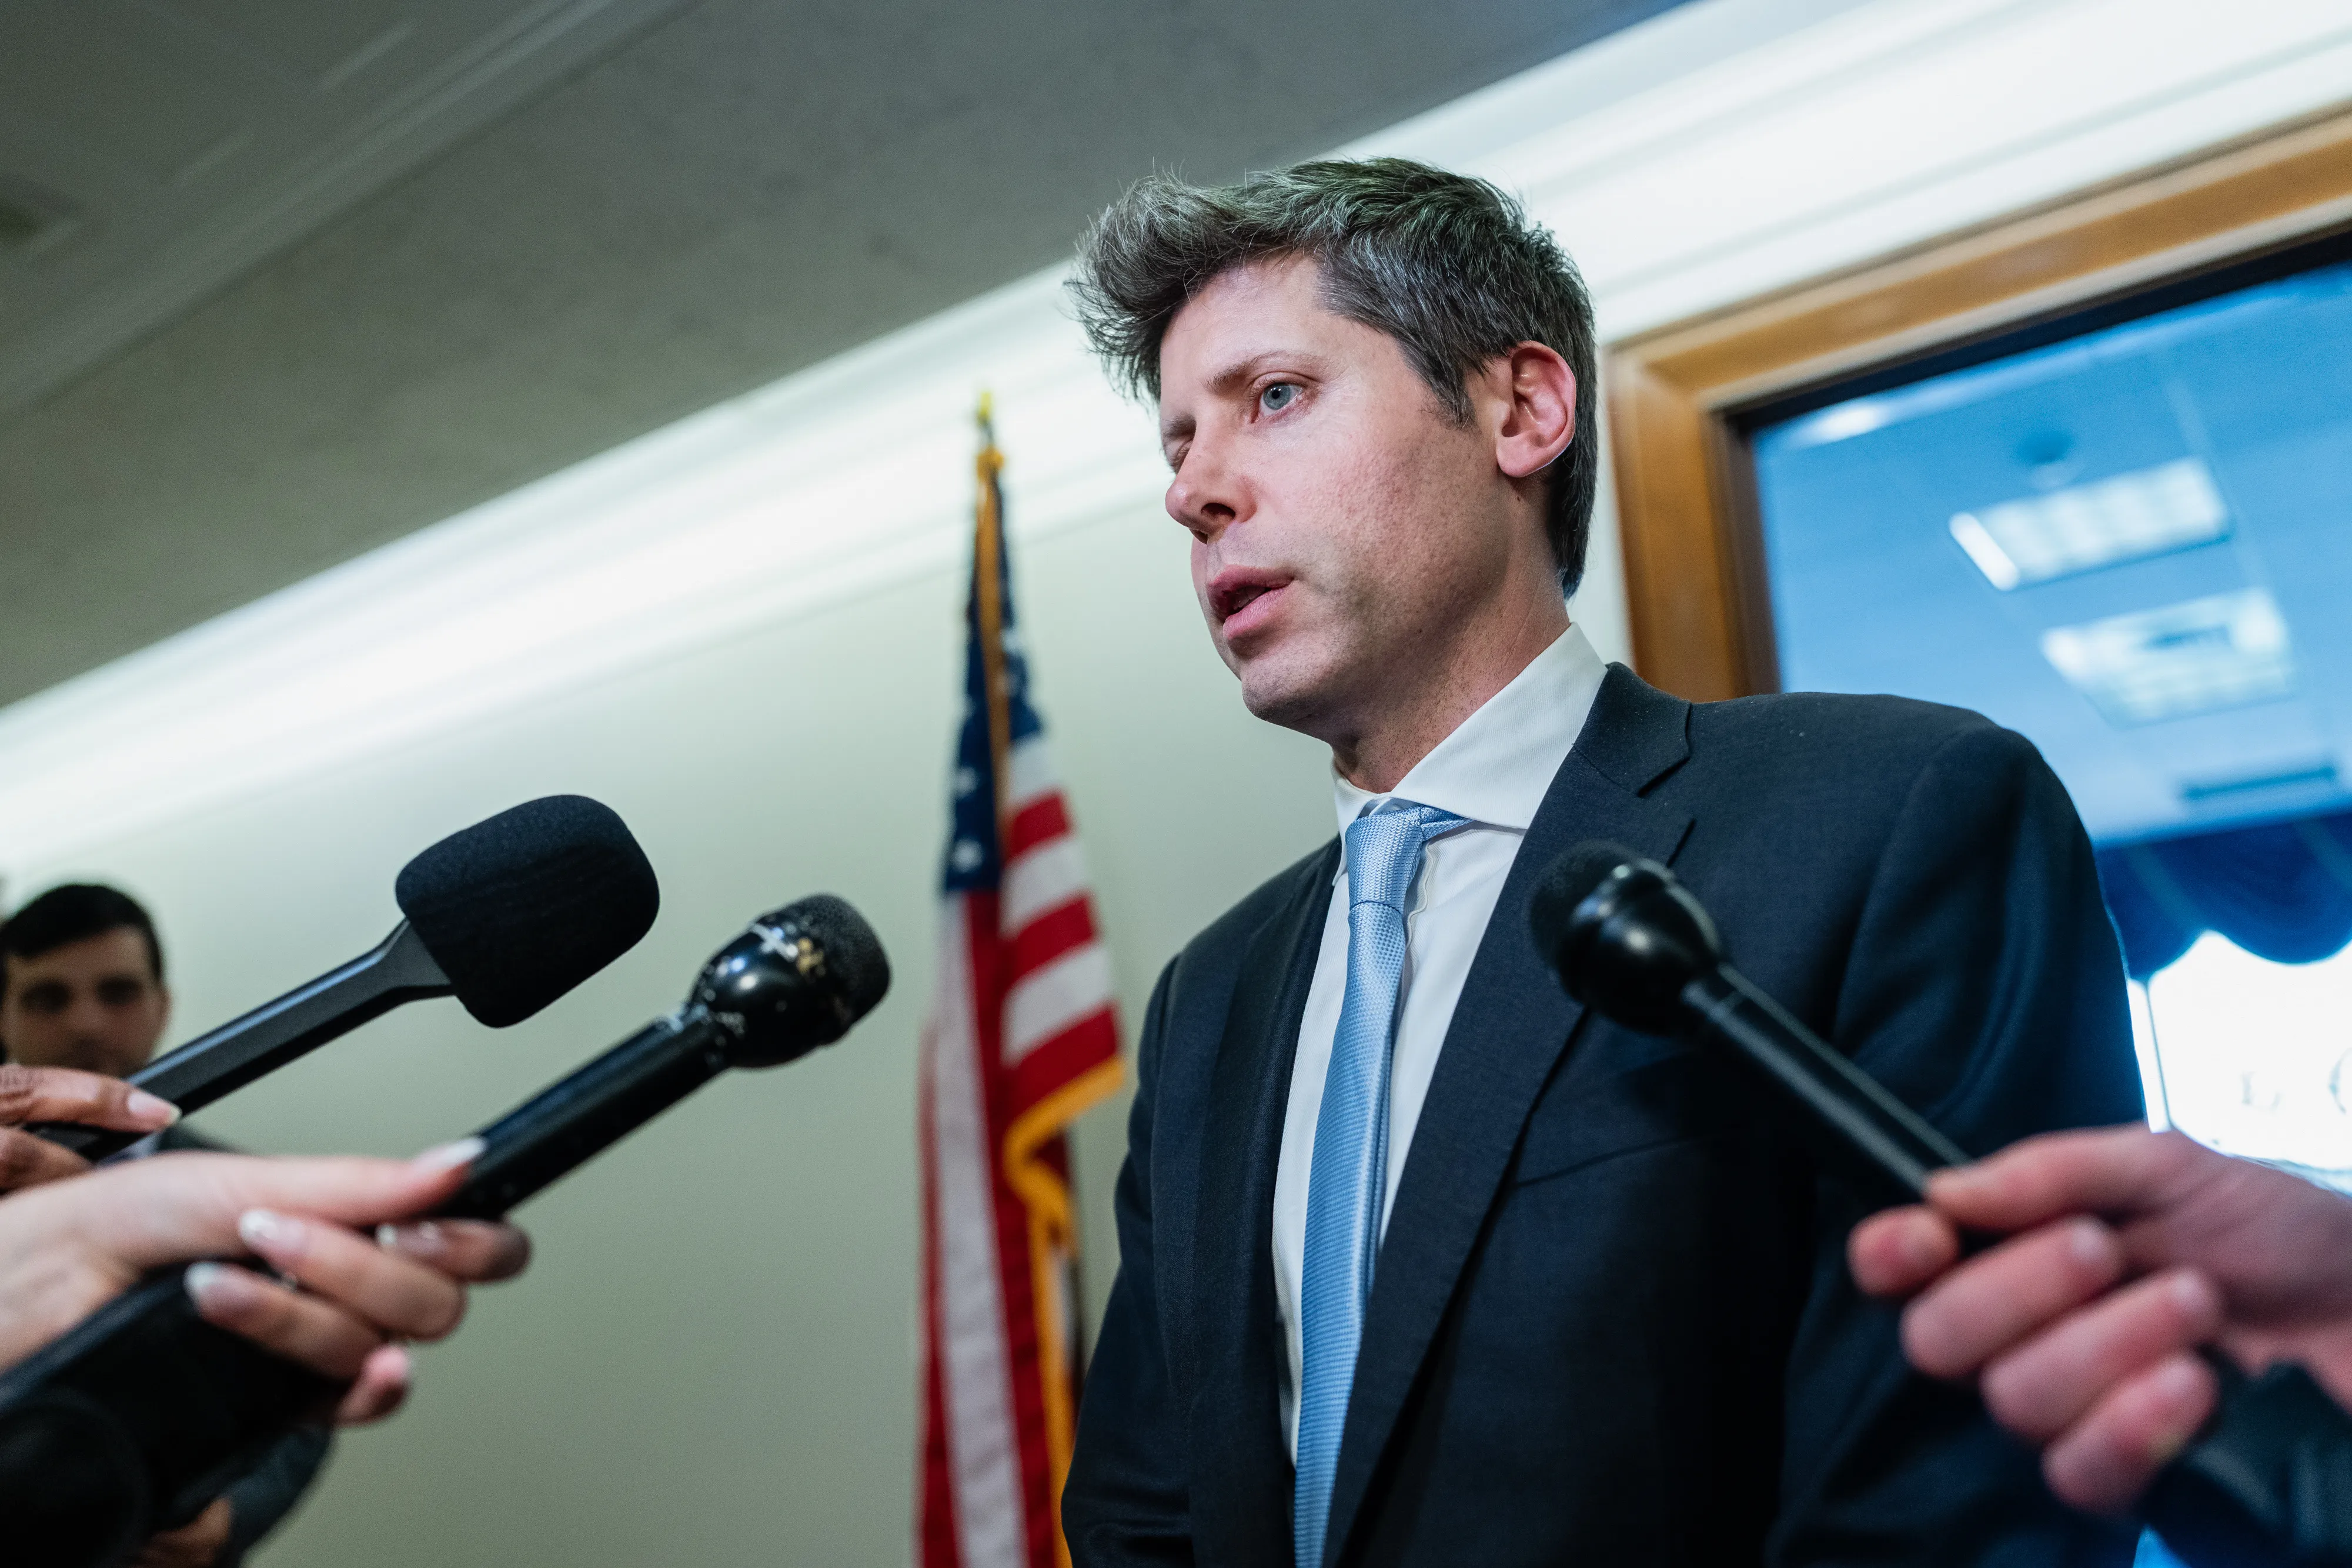
A OpenAI cometeu um "roubo impressionante de proporções sem precedentes" ao utilizar milhões de artigos jornalísticos para treinar seus modelos de inteligência artificial (IA), alegou o New York Times em um documento judicial tornado público nesta quinta-feira. A startup californiana teria extraído conteúdo de mais de 10 milhões de artigos, quase um terço deles provenientes do próprio New York Times. Tribunal: Juíza determina compartilhamento de dados e outras medidas con
A OpenAI cometeu um "roubo sem precedentes" ao utilizar milhões de artigos jornalísticos para treinar seus modelos de inteligência artificial (IA), afirmou um funcionário da Microsoft que estava a par da operação, revela documento judicial tornado público nesta quinta-feira. De acordo com o processo, a startup teria extraído conteúdo de mais de 10 milhões de artigos para treinar sua IA. Quase um terço deles era proveniente do NYT, que move ação contra a empresa de Sam Altman e a Microsoft por violação de direitos autorais.
O documento traz declarações do diretor de Ciência Aplicada da Microsoft, Brent Hecht, que classifica o uso das reportagens como "um roubo impressionante de proporções sem precedentes" e possivelmente "o maior roubo de trabalho da história da humanidade".
A Microsoft é uma das investidoras da OpenAI. Procurada, ela disse em nota que as declarações de Hecht representam "a opinião pessoal de um funcionário" e "não refletem a posição da empresa".
Em um memorando de 2023 anexado ao processo, Nick Turley, que liderava a equipe responsável pelo desenvolvimento do ChatGPT, chega a falar em "ameaça existencial" das editoras pelos novos modelos de IA.
A Microsoft, por sua vez, reconhece que as taxas de clique para o conteúdo original usado pelo modelo de IA eram de 83% a 93% menores entre o número de usuários de suas ferramentas, em comparação com o mecanismo de busca tradicional na internet. Ou seja, ao buscar uma informação em um chatbot, o usuário clica menos no link que contém o dado original.
A petição também afirma que a OpenAI empregou técnicas “transgressoras e enganosas” para obter conteúdo protegido por paywall e que Greg Brockman, hoje presidente da OpenAI tinha conhecimento da prática, segundo o britânico Financial Times. Ainda segundo o jornal, quando foi informado por um funcionário sobre “um hack para contornar o paywall do New York Times”, Brockman teria respondido: “ah, legal”.
Trechos dessas discussões foram tornados públicos nesta quinta-feira no âmbito de um processo movido pelo NYT contra a OpenAI e a Microsoft há três anos em um tribunal federal de Nova York. O NYT acusa as empresas de utilizarem indevidamente material protegido por direitos autorais para treinar o ChatGPT, principal modelo da OpenAI. A companhia de Bill Gates fez seu primeiro investimento na OpenAI em 2019.
Satya Nadella, presidente-executivo da Microsoft, afirmou em depoimento aos advogados que “qualquer conteúdo protegido por paywall deveria ser licenciado por qualquer pessoa que queira utilizá-lo”. Ele disse ainda que, se “tivesse sido informado de que a OpenAI havia coletado e treinado seus modelos com informações que estavam atrás de um paywall”, teria invocado o direito da Microsoft de exigir que a OpenAI treinasse novamente seus modelos.
Adesões ao processo judicial
Diversos outros grupos de mídia também aderiram à ação judicial, entre eles a Ziff Davis, proprietária do CNET e de outras publicações de tecnologia, além da empresa controladora da revista Mother Jones, o site de jornalismo investigativo The Intercept e vários jornais locais dos Estados Unidos. Os autores da ação pedem indenização por cada artigo que teria sido utilizado pelos modelos da OpenAI, embora ainda não esteja claro o valor total que poderá ser determinado pela Justiça.
Desde o lançamento do ChatGPT, no fim de 2022, a OpenAI assinou acordos de licenciamento de conteúdo com muitos veículos de imprensa ao redor do mundo. Ainda assim, persistem preocupações de que os sistemas de IA generativa estejam reduzindo o tráfego para sites de notícias na internet.
As empresas de IA tentaram responder a essas críticas ao incluir citações e links nas respostas fornecidas aos usuários, mas a iniciativa foi considerada insuficiente por parte dos críticos.
"Por mais destaque que demos aos links, os usuários não vão clicar neles", admitiu um dos próprios engenheiros da OpenAI, segundo o documento judicial.
Princípio do uso legítimo
A OpenAI e a Microsoft alegam que o uso de conteúdos do New York Times está amparado pelo princípio do fair use (uso legítimo), uma exceção da legislação de direitos autorais dos Estados Unidos que permite, em determinadas circunstâncias, a utilização de obras sem consentimento. As empresas também argumentam que o desenvolvimento da IA envolve uma transformação do conteúdo utilizado e não a sua pura replicação.
No início de setembro, o Departamento de Justiça dos Estados Unidos apresentou um parecer em apoio à OpenAI e à Microsoft, citando o "progresso científico", o crescimento econômico e a "segurança nacional". Os autores da ação solicitaram uma sentença sumária favorável. Caso o juiz federal Sidney Stein acolha o pedido, o processo não seguirá para julgamento, mas uma decisão não é esperada antes de 2027.
A OpenAI não se manifestou, e o NYT não quis fazer comentários.

0 Comentário(s)
Deixe seu comentário